| Задача | Контроль качества DXA-исследований: бинарная оценка «качественное / есть нарушение», определение анатомической области, тип нарушения, структурированный отчёт |
|---|---|
| Дата документа | 27 сентября 2026 г. |
| Команда | Грачев Денис — разработка; Грачев Татьяна — капитан |
| Версия решения | 1.0.0 (src/__init__.py) |
| Рабочий чекпоинт | models/dxa_model.pth: ResNet18 + линейная голова, разметка table, seed 42, эпоха 39, порог логита −0.4930 (вероятность 0.379) |
| Ключевые метрики | ROC-AUC 0.6764 [0.6309, 0.7218], F1 0.5676 [0.5270, 0.6082] — пять seed'ов на фиксированном разбиении по исследованиям |
| Время обработки | 0.021 с на изображение (медиана, CPU), 548 файлов за 12.1 с; требование «≤ 3 мин на исследование» выполняется с запасом |
Документ описывает фактическое состояние репозитория на дату, указанную на титуле: все параметры, пороги, метрики и имена полей приведены по коду и по выполненным измерениям, а не по проектным намерениям. Там, где значение измерено на конкретной машине, указано, на какой. Расхождения и ограничения перечислены явно — разделы 15 и 16.
Сервис принимает денситометрическое исследование в формате DICOM и выполняет автоматизированный контроль его качества: определяет анатомическую область, решает бинарную задачу «изображение пригодно для клинической интерпретации / содержит нарушение качества», относит нарушение к категории и формирует структурированный отчёт (XLSX/CSV) с одной строкой на изображение.
Задача решается как цифровой помощник, а не как замена врача: результат предназначен для отбора исследований, требующих внимания специалиста, и для единообразной регистрации нарушений. Области анализа — поясничный отдел позвоночника и проксимальный отдел бедренной кости (левая и правая стороны рассматриваются как отдельные снимки, поскольку сторона влияет на трактовку критериев).
Решение работает полностью офлайн: изображения не передаются во внешние сервисы, все зависимости и веса фиксированы, доступ в сеть при инференсе не требуется. Это прямое требование методики (п. 3.2 задания) и одновременно условие применимости в закрытом контуре медицинской организации.
Таблица связывает пункты задания с реализацией и со способом проверки. Формулировки требований приведены по тексту методических рекомендаций.
| Требование | Реализация | Чем подтверждается |
|---|---|---|
| Области: поясничный отдел позвоночника и проксимальный отдел бедренной кости | Область определяется автоматически по кадру; бедро разделяется на левое и правое | Разд. 7; на валидации 99/99 для позвоночника |
| Бинарная классификация «качественное / есть нарушение» | ResNet18 (ImageNet) + линейная голова, порог по логиту, подобранный по F1 | Разд. 6, 12; tests/test_preprocess_and_model.py |
| Определение типа нарушения | Единый словарь кодов src/dxa/violations.py; отнесение к категории — по измеряемым признакам снимка |
Разд. 8; tests/test_violations.py |
| Оценка корректности разметки анатомических структур | В наборе нет ROI-разметки в DICOM, поэтому оценивается геометрия видимой зоны измерения и её границы | Разд. 8, 17 (ограничение 4) |
Отчёт .xlsx/.csv, одна строка на изображение, столбцы из п. 2.5 |
CLI-инференс и POST /api/v1/export; обязательные восемь столбцов плюс три диагностических |
Разд. 9 (состав столбцов проверен на реальном прогоне) |
| Время обработки одного исследования ≤ 3 мин | Один снимок — один прямой проход сети 224×224, без итеративных процедур | Разд. 13: 0.021 с медиана на CPU, запас более чем трёхкратный |
| Отсутствие необработанных исключений; ошибки фиксируются в отчёте | Ошибка на файле не прерывает пакет: строка получает processing_status = Failure: … |
Разд. 16 |
| Воспроизводимость при повторном запуске | Фиксированный seed, зафиксированное разбиение в файле, версии зависимостей, самодостаточный чекпоинт | Разд. 6, 14; tests/test_labels.py |
| Пакетная обработка архива + общая таблица + zip с дополнительными сериями | Обход каталога, лог прогресса, XLSX/CSV, опциональный zip с визуализацией | Разд. 9, 13 |
| API для пакетной обработки тестового набора | FastAPI: восемь маршрутов, включая /api/v1/batch и /api/v1/export |
Разд. 10 |
| Обязательная контейнеризация, скрипт сборки и запуска в Linux | Dockerfile (python:3.11-slim, чекпоинт внутри образа), Dockerfile_cuda для GPU, docker-compose.yml на оба случая, run.sh |
Разд. 14; сборка и запуск проверены, см. 14 |
| Фиксация зависимостей, включая базовый контейнер | requirements.txt с точными версиями, базовый образ по тегу, torch с CPU-индексом (CPU-вариант) и cu126 (GPU-вариант) |
Разд. 14 |
| Работа без обращения к внешним сервисам | Офлайн-ассеты фронтенда, отсутствие сетевых вызовов в коде предсказания | tests/browser/ui_offline.js |
| Полный комплект документации | README.md (обзор и воспроизведение), assets/labeling.md (разметка и её обоснование), docs/technical-description.html и .pdf (данный документ) |
— |
| Слой | Файлы | Ответственность |
|---|---|---|
| Прикладной ядерный слой | src/dxa/ |
Чтение DICOM, предобработка, модель, метрики, определение области, разметка данных, обучение, пакетный инференс |
| Сервис | src/main.py |
FastAPI: загрузка чекпоинта при старте, маршруты анализа, пакетной обработки, экспорта, здоровья и карточки решения |
| Веб-интерфейс | src/api/static/ |
Загрузка файлов, таблица результатов, панель деталей, панель «О модели»; все подписи и метрики получает с сервера |
| Эвристики качества | src/quality/ |
Числовые измерения снимка (резкость, плотные включения, полнота и поворот области) для панели деталей |
| Инфраструктура | run.sh, docker-compose.yml, Dockerfile, Dockerfile_cuda, Jenkinsfile |
Единая точка входа для сборки, обучения, инференса и тестов; сборка образа и выкладка |
Ниже — фактический путь данных от файла до строки отчёта. Ключевое свойство: обучение и сервис используют один и тот же код предобработки и предсказания, поэтому расхождение между офлайн-оценкой и работой API невозможно по построению, а не по договорённости.
| DICOM | → | Чтение пикселей и метаданных | → | Предобработка 224×224 | → | ResNet18 + линейная голова |
|---|---|---|---|---|---|---|
| Логит → порог | → | Область по кадру | → | Числовые измерения | → | Строка отчёта / ответ API |
Порядок операций и точка принятия решения:
StudyInstanceUID, SOPInstanceUID). Персональные данные не используются:
решение не зависит от их наличия.quality_class = 1, если логит выше порога. Порог подобран по F1 на валидации и
сохранён в чекпоинте (текущее значение −0.4930, что соответствует вероятности 0.379).README.md приведён полный набор проектных диаграмм (компоненты, потоки данных,
последовательность, развёртывание). Они описывают целевую архитектуру, включая блоки, которые в текущей
реализации не используются, поэтому в настоящем документе поток описан текстом по коду.| Показатель | Значение | Пояснение |
|---|---|---|
| Файлов на диске | 544 | в обучающем наборе (dataset_hack/НД_для_обучения) |
| Уникальных снимков | 252 | по пиксельному содержимому; 292 файла — побайтные дубли |
| Исследований | 100 | разбиение выполняется по исследованиям, а не по снимкам |
| Позвоночник / бедро правое / бедро левое / не определено | 99 / 79 / 73 / 1 | голосование по именам файлов после склейки дублей |
| Нарушений по экспертной таблице | 74 (29.4 %) | три снимка таблица не оценивала |
| Нарушений в рабочей разметке | 77 (30.6 %) | 74 по таблице плюс 3 снимка с пометкой в имени файла |
Дубли не пересекают границы исследований, конфликтов меток при склейке не возникает. Два побайтных дубля названы по-разному, поэтому область определяется голосованием по именам файлов. Изучение набора выявило две особенности, которые пришлось учесть в разметке: один и тот же снимок встречается под несколькими именами (без склейки он попадал бы одновременно в оба класса), и имена файлов местами расходятся с оценкой эксперта.
Экспертная таблица описывает исследование, а не отдельный снимок. Однако каждая
анатомическая область встречается в исследовании ровно один раз (после склейки дублей), поэтому
вердикт исследования по области переносится на снимок однозначно — не требуется решать, какой из
нескольких снимков «плохой». Так получены метки и типы нарушений (labels/labels_images.csv);
каждый источник свидетельства сохранён в отдельном столбце, поэтому правило можно переиграть без
повторного разбора данных.
Возможны были два правила: учитывать только экспертную таблицу либо дополнительно учитывать
пометки _good/_bad, проставленные вручную в именах файлов. Пометки
расходились с экспертом в 15 случаях из 252, поэтому правило выбиралось измерением: одно
зафиксированное разбиение, пять seed'ов обучения, один эталон (табл. в разд. 12.3). Выбрано правило
«только экспертная таблица».
| Часть | Снимков | Исследований | Нарушений | Файл |
|---|---|---|---|---|
| Обучение | 199 | 81 | 61 | labels/split_expert_seed42.json |
| Валидация | 53 | 19 | 16 |
Разбиение стратифицировано по эталону и фиксировано в файле: все сравниваемые варианты
обучаются и оцениваются на одном и том же held-out наборе, что делает сравнения корректными.
Снимки одного исследования не попадают одновременно в обе части — это исключает утечку, при которой
метрики растут за счёт запоминания конкретных исследований. Наличие утечки и воспроизводимость
разбиения проверяются тестами (tests/test_labels.py).
Предобработка описана декларативно в src/dxa/preprocess.py (неизменяемая конфигурация
PreprocessConfig) и используется и при обучении, и при работе API. Параметры хранятся в
чекпоинте и восстанавливаются из него, поэтому вход модели не может разойтись между двумя режимами.
| Параметр | Значение | Назначение |
|---|---|---|
norm | percentile | приведение интенсивностей к [0, 1]; допустимо также minmax |
p_low / p_high | 0.5 / 99.5 | отсекаемые перцентили — устойчивость к выбросам и шуму |
imagenet_norm | true | стандартизация mean (0.485, 0.456, 0.406), std (0.229, 0.224, 0.225), как ожидает предобученный backbone |
input_size | 224 | сторона квадратного входа сети |
Порядок операций над одним файлом:
pydicom.dcmread и pixel_array в float32;
многокадровое изображение усредняется по кадрам, иная размерность — ошибка.RescaleSlope и
RescaleIntercept; для MONOCHROME1 яркость инвертируется.hi ≤ lo).uint8, дублирование одного канала
в три, resize 224×224 билинейно, перевод в CHW, деление на 255, затем нормировка ImageNet.Если в чекпоинте нет блока preprocess (старый файл), применяются значения по умолчанию —
percentile с нормировкой ImageNet; устаревший профиль minmax без ImageNet
доступен флагом --no-imagenet-norm.
uint8, затем нормировка» сохранён намеренно: он совпадает
с историческим кодом проекта, поэтому смена реализации не сдвинула распределение входа и не обесценила
ранее подобранный порог.| Элемент | Реализация |
|---|---|
| Backbone | ResNet18 с весами ImageNet (IMAGENET1K_V1), все слои кроме
fc; признак — 512 чисел. Флагом --backbone допустим также
ResNet34 |
| Голова качества | по умолчанию linear: Flatten + Linear(512, 2) — линейный
зонд, 1026 обучаемых параметров. Режим mlp (флаг --head):
Linear(512, 256) + ReLU + Dropout(0.3) +
Linear(256, 2) |
| Вспомогательная голова области | Flatten + Linear(512, 4): три анатомические области плюс «неизвестно».
Обучается с весом 0.3 как дополнительная задача и заставляет backbone различать анатомию; логиты
качества она не сдвигает |
| Стандартизация входа головы | признаки нормируются по среднему и СКО обучающей выборки, зафиксированным в буферах
feat_mean/feat_std. Без неё логиты смещены, вероятности скучены у нуля и
подобранный порог теряет смысл |
| Параметр | Значение по умолчанию | Комментарий |
|---|---|---|
| Оптимизатор | AdamW | lr 3e-4, weight_decay 5e-2. Заметный weight decay нужен не только
против переобучения: без него логиты за 100 эпох насыщаются и порог вырождается |
| Планировщик | ReduceLROnPlateau | множитель 0.5, терпение 3, следит за val_loss |
| Функция потерь | CrossEntropy | балансировка классов выключена (--balance none); доступны loss
(вес n_good / n_bad) и sampler |
| Батч / эпохи | 16 / 100 | ранняя остановка после 25 эпох без улучшения |
| Отбор чекпоинта | окно 5 | оценка эпохи — ROC-AUC, сглаженный по последним 5 эпохам; до заполнения окна чекпоинт не сохраняется, при равном AUC решает F1 |
| Вес головы области | 0.3 | --region-loss-weight; снимки с неизвестной областью в её loss не входят |
| Обрезка градиентов | норма 5.0 | защита от выбросов |
| Заморозка backbone | всегда | --freeze-epochs -1 по умолчанию (линейный зонд); при размораживании lr падает
в 10 раз |
| Seed / устройство | 42 / авто | порядок выбора устройства: CUDA → MPS → CPU |
Почему линейный зонд. При ~250 уникальных снимках полный fine-tune ResNet18 за несколько эпох
запоминает обучающую выборку: train F1 стремится к 1.0, а val AUC падает к 0.5. Поэтому по умолчанию
backbone заморожен и обучается только голова на признаках ImageNet. При заморозке слои BatchNorm
остаются в режиме eval: иначе бегущие статистики продолжали бы обновляться и признаки
«уезжали» бы от тех, на которых рассчитывалась стандартизация.
Почему порог по логиту. Порог хранится и применяется в логитах (log-odds): после обучения линейный зонд разделяет обучающую выборку почти идеально, вероятности насыщаются в 0/1, и порог в единицах вероятности вырождается. Для человека порог переводится в вероятность через сигмоиду. ROC-AUC и PR-AUC считаются по вероятностям и от порога не зависят.
Как подбирается порог. На каждой эпохе по валидации: кандидаты — все наблюдаемые логиты плюс
края диапазона, выбирается максимум F1; при равном F1 берётся меньший логит, чтобы не терять recall.
Аргумент --min-recall позволяет вместо этого взять максимальный порог с recall не ниже
заданного.
Рабочий чекпоинт. Лучшая эпоха — 39 из прогона в 64 эпохи (обучение остановлено по терпению), порог логита −0.4930 (вероятность 0.379). Метрики этой эпохи — в разделе 12, честная оценка варианта на пяти seed'ах — ROC-AUC 0.6764.
Чекпоинт самодостаточен: кроме весов в нём лежат архитектура, параметры предобработки, порог и происхождение данных, поэтому инференс не может рассинхронизироваться с обучением.
| Поле | Содержимое |
|---|---|
model_state_dict | веса сети; format_version — 2 |
backbone, head | архитектура; при явном расхождении с запрошенной загрузка завершается ошибкой |
preprocess | параметры предобработки (раздел 5) |
threshold, threshold_logit | рабочий порог по логитам |
labels_csv, split_file | на какой разметке и на каком разбиении обучена модель |
epoch, val_metrics, selection_score | эпоха, её метрики и сглаженная оценка, по которой выбран чекпоинт |
history, optimizer_state_dict | история обучения и состояние оптимизатора |
Рядом с чекпоинтом обучение пишет train_report.md и train_report.json:
гиперпараметры, метрики на валидации, метрики по областям и историю по эпохам. Артефакты кладутся в
--output-dir (по умолчанию models).
Область определяется по содержимому снимка, а не по имени файла: на закрытом наборе соглашение об
именах может отсутствовать. Решение принимается по геометрии кадра (resolve_region в
src/dxa/inference.py) независимо от модели качества; обученная вспомогательная голова
области привлекается только как уточнение.
Признаки считает функция heuristic_signals по маске яркой (костной) ткани с порогом по
95-му перцентилю:
| Признак | Что измеряет |
|---|---|
width | ширина кадра в пикселях — основной признак области на этом оборудовании (у позвоночника 300 px, у бедра 280 px) |
bbox_aspect | отношение высоты яркой области к её ширине (вытянутость) |
left_right_ratio | перевес светимости левой половины над правой — наклон в сторону бедра |
symmetry | симметрия изображения относительно вертикальной оси |
Порог ширины задан константой SPINE_MIN_WIDTH = 295. Порядок решений:
spine, уверенность 0.8;left_right_ratio > 1.3 даёт
hip_right, < 0.7 — hip_left, уверенность 0.6;hip с уверенностью 0.4.Если ширина кадра неизвестна, используется предсказание головы, а затем форма яркой области
(bbox_aspect и symmetry).
Точность. Сопоставление с областью из рабочей разметки (252 снимка, раздел 4):
| Что проверялось | Результат |
|---|---|
| Позвоночник | 99 / 99 |
| Сторона бедра (правое / левое) | 135 / 152 (88.8 %) |
| Итого по всем областям | 234 / 251 (93.2 %) |
Различение позвоночника и бедра по ширине кадра работает безошибочно, а сторона бедра определяется
менее надёжно: перевес светимости путает левое и правое в 17 случаях из 152. Сторона не проверялась по
тегам DICOM — Laterality в наборе пуст, — поэтому это ограничение (раздел 17, п. 7), а не
измеренная ошибка модели.
Коды типов нарушений собраны в одном модуле src/dxa/violations.py. Раньше словарь был
свой в трёх местах (инференс, main.py и веб-интерфейс), и ни одна копия не знала кодов
экспертной таблицы; теперь коды, русские подписи и пояснения заданы один раз, а сервер отдаёт их
клиенту.
| Код | Подпись | Область | Источник |
|---|---|---|---|
positioning | Некорректная укладка | spine | экспертная таблица |
axis_deviation | Отклонение оси | spine | экспертная таблица |
artifact | Артефакты и импланты | любая | экспертная таблица |
rotation | Ротация / позиционирование | hip | экспертная таблица |
roi_incorrect | Некорректная область интереса | любая | экспертная таблица |
motion | Движение, размытие | любая | condition_doctor.txt |
incomplete_anatomy | Анатомия видна не полностью | любая | condition_doctor.txt |
labeling_error | Ошибка разметки | spine | condition_doctor.txt |
unspecified | Нарушение без уточнения | любая | системный код |
У каждого кода есть пояснение, чем нарушение мешает измерению (например, для rotation —
что малый вертел виден слишком хорошо и шейка бедра кажется укороченной). Функция
catalogue() отдаёт словарь через /api/v1/model, поэтому подписи в интерфейсе и
в выгрузке не могут разойтись с кодами.
Для текстового отчёта DICOM SR у каждого кода заданы условный числовой код и английская формулировка.
Полноценного справочника SNOMED/DICOM для контроля качества DXA в наборе нет, поэтому коды условные и
всегда идут рядом с текстом: пригодный снимок кодируется 113001 (DXA image quality
acceptable) с флагом FINAL, нарушение — с флагом WARNING. Устаревшие значения
внешних источников (artifact_motion, roi_error, position_error,
quality_violation_detected и другие) приводит к канону функция canon_type.
Экспертная таблица кодирует не все девять кодов, а пять: positioning,
axis_deviation, artifact, rotation, roi_incorrect.
Распределение в рабочей разметке (в четырёх из 77 нарушений указано по два критерия, поэтому сумма
больше 77):
| Код | Снимков |
|---|---|
rotation | 36 |
artifact | 17 |
axis_deviation | 10 |
roi_incorrect | 7 |
positioning | 6 |
unspecified | 5 |
Коды motion, incomplete_anatomy и labeling_error в разметке не
встречаются: таблица их не кодирует, хотя словарь их знает ради критериев
condition_doctor.txt. Пять снимков имеют только unspecified, потому что
источник не указывает критерий.
Модель решает только бинарную задачу, поэтому тип для снимка с нарушением выбирает функция
classify_violation_type по дешёвым признакам: размытие
(laplacian_variance), доля плотных пикселей (bright_fraction) и вытянутость
яркой области (bbox_aspect для бедра). При отсутствии выраженного признака возвращается
unspecified.
motion_threshold и artifact_threshold в вызов не передаются, поэтому
действуют значения по умолчанию (0.0 и 1.0), которых признаки достичь не могут, а условие ротации
(bbox_aspect вне диапазона 0.4–3.0) на наборе не срабатывает. Прогон по всем 548 файлам
даёт одинаковый результат: все 341 решение с нарушением помечены unspecified. Для
содержательного типа нужна разметка типов на уровне снимка и обученный мультилейбл-классификатор
(раздел 18), поэтому в ответе API тип всегда идёт с флагом
violation_type_is_heuristic = true.Один файл DICOM (для API — один HTTP-загрузкой, для CLI — файл или каталог с рекурсивным обходом). Исследование может содержать несколько снимков — каждый обрабатывается отдельно и даёт отдельную строку отчёта. Перед обработкой файл читается целиком; при ошибке чтения строка получает статус сбоя, а пакет продолжается.
Состав столбцов проверен на реальных прогонах — и через CLI, и через /api/v1/export.
Обязательные восемь столбцов задания совпадают в обоих путях по составу и порядку; дополнительно
пишутся confidence и violation_reason, а CLI-инференс добавляет одиннадцатый
столбец region_confidence. Таблица ниже отражает CLI-вывод; в ответе
/api/v1/export последнего столбца нет.
| № | Столбец | Тип | Содержимое |
|---|---|---|---|
| 1 | path_to_study | строка | путь к исследованию (для загрузки через API — upload://имя) |
| 2 | study_uid | строка | StudyInstanceUID из DICOM |
| 3 | image_uid | строка | SOPInstanceUID из DICOM |
| 4 | anatomical_region | строка | spine / hip_left / hip_right / hip |
| 5 | quality_class | целое | 0 — качественное, 1 — есть нарушение |
| 6 | violation_type | строка | код нарушения или пусто |
| 7 | processing_status | строка | Success либо Failure: <причина> |
| 8 | time_of_processing | вещественное | время обработки снимка, секунды |
| 9 | confidence | вещественное | уверенность модели в решении |
| 10 | violation_reason | строка | текстовое пояснение к отнесённой категории |
| 11 | region_confidence | вещественное | уверенность определения области |
POST /api/v1/analyze этого столбца не содержит — при интеграции время измеряется на
стороне вызывающей системы (см. разд. 10 и 13).Сервис на FastAPI. Маршруты и состав полей ответов ниже приведены по фактическим ответам на запросах к тестовым файлам, а не по схеме из документации кода.
| Метод | Путь | Назначение |
|---|---|---|
| GET | / | веб-интерфейс |
| GET | /api/v1/health | статус сервиса; поля ответа: status, device, model_loaded, model |
| GET | /api/v1/model | карточка решения: model, labels, dataset, comparison, violations, limitations, sources, snapshot_date, loaded |
| POST | /api/v1/analyze | анализ одного файла (multipart-загрузка) |
| POST | /api/v1/analyze/detailed | расширенный отчёт, опционально с маской |
| POST | /api/v1/analyze/sr | текстовое представление отчёта DICOM SR: format, sr_content, UID |
| POST | /api/v1/batch | пакетная обработка нескольких файлов |
| POST | /api/v1/export | пакетная обработка и выгрузка в XLSX |
/api/v1/analyzeПоля: filename, study_uid, image_uid,
anatomical_region, region_confidence, quality_class,
quality_label, overall_quality, severity,
confidence, confidence_per_class, threshold_probability,
violation_type, violation_type_label,
violation_type_is_heuristic, violation_type_note, reason,
metrics, samples, processing_status.
Два поля заслуживают пояснения при интеграции:
violation_type_is_heuristic = true — тип нарушения определён по измеряемым признакам
снимка, а не предсказан моделью; модель решает только бинарную задачу. Флаг отдаётся клиенту
явно, чтобы это различие не терялось в интеграции.quality_label, violation_type_label, violation_type_note —
готовые подписи для интерфейса. Они приходят с сервера: клиент не держит собственных копий
словаря, поэтому подписи не могут разойтись с кодами./api/v1/analyze/detailedДополнительно к предыдущему набору: image (визуализация снимка), mask
(маска зоны измерения, при запросе), reasons, metrics_note,
view_quality, а также измерения по областям: spine_completeness,
hip_completeness, hip_rotation.
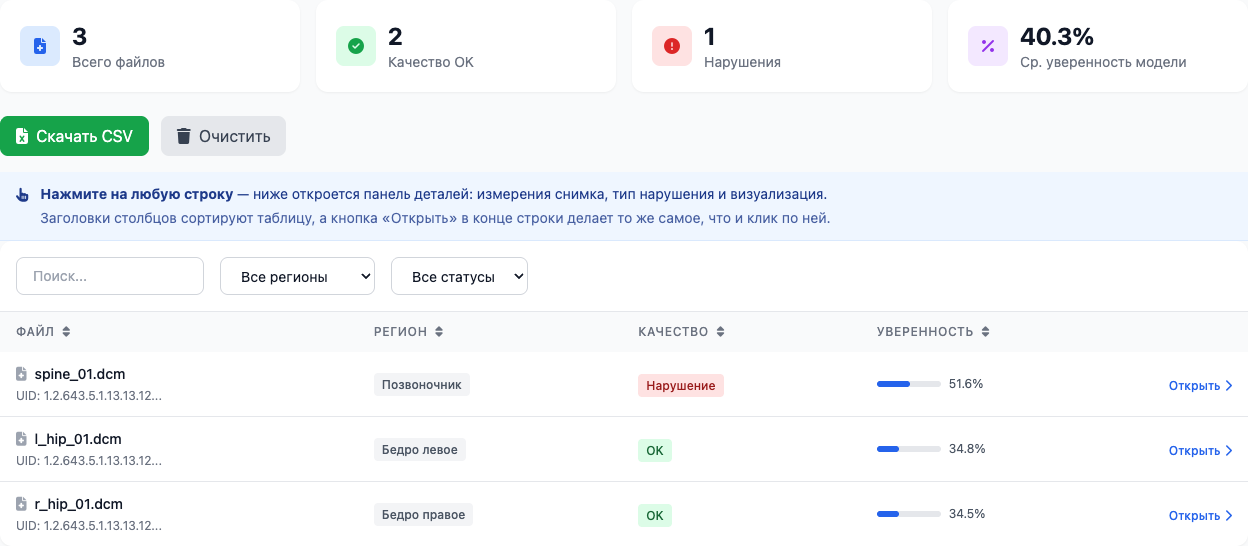
Интерфейс предназначен для ручной проверки работы сервиса и для демонстрации: загрузка файлов, таблица результатов со статистикой, панель деталей по выбранной строке и панель «О модели» с источником загруженного чекпоинта.
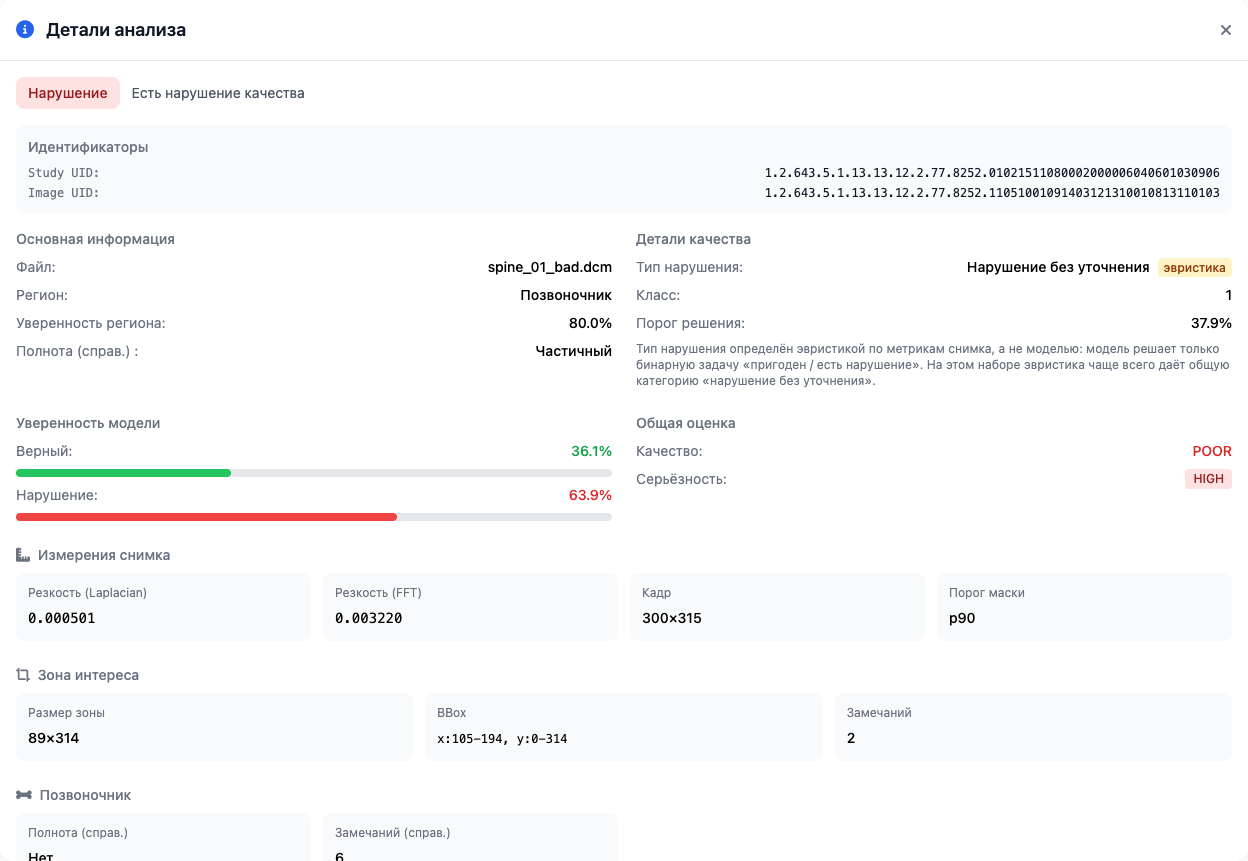
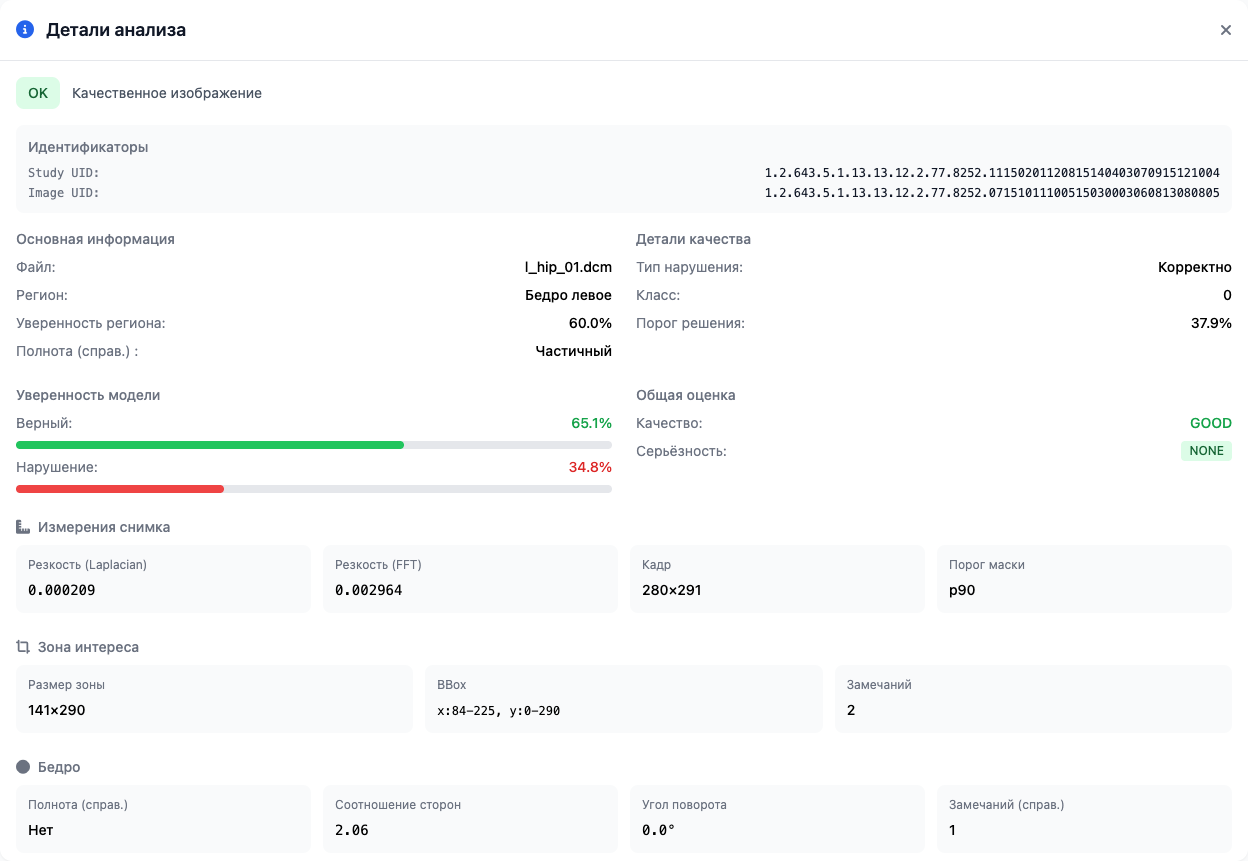
Отдельный принцип — интерфейс не утверждает больше, чем известно решению:
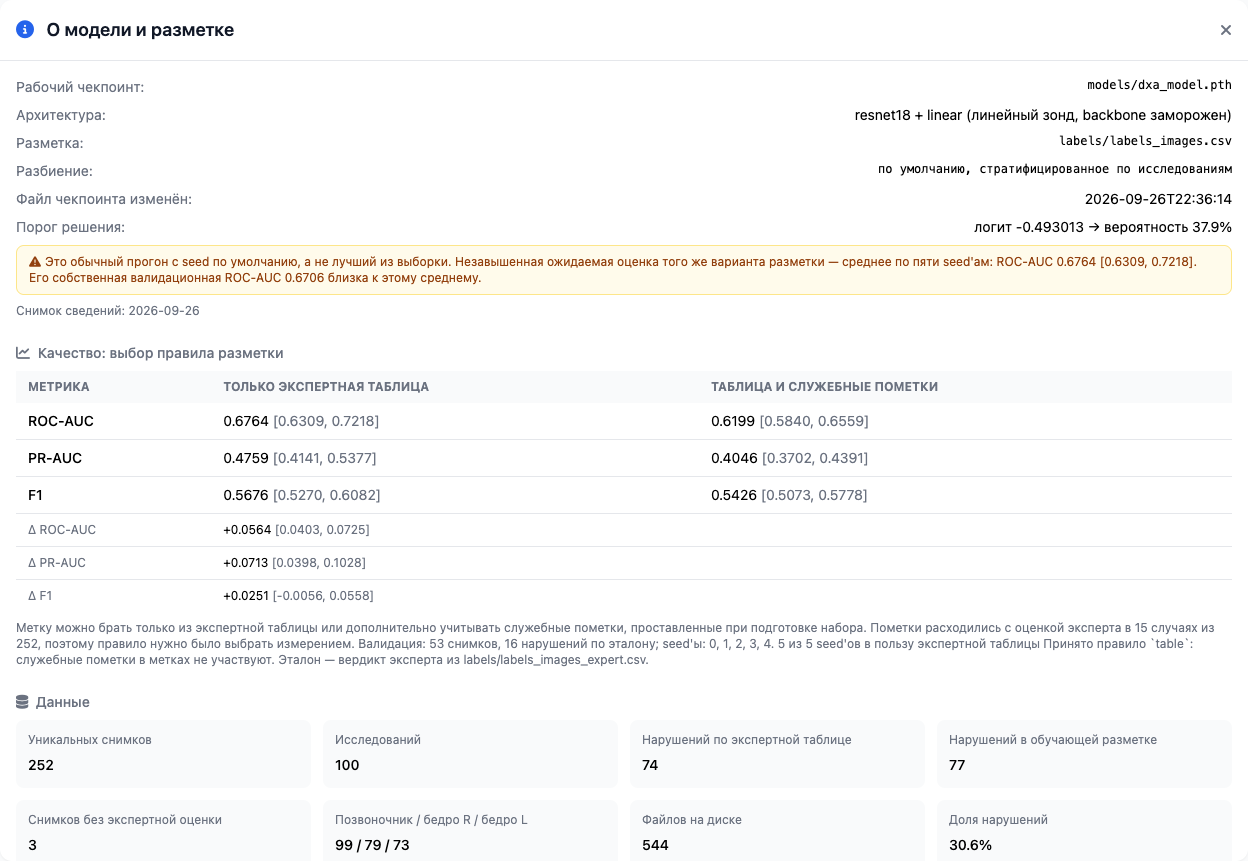
/api/v1/model.Оценка получена на фиксированном разбиении по исследованиям (обучение 199 снимков / 81 исследование, валидация 53 снимка / 19 исследований, 16 нарушений), пять seed'ов обучения, эталон — вердикт эксперта из таблицы. Приоритетные по заданию метрики приведены с 95 % доверительными интервалами.
| Метрика | Значение | 95 % ДИ | Комментарий |
|---|---|---|---|
| ROC-AUC | 0.6764 | [0.6309, 0.7218] | приоритетная метрика задания |
| PR-AUC | 0.4759 | [0.4141, 0.5377] | базовый уровень при доле нарушений 30 % — около 0.30 |
| F1 | 0.5676 | [0.5270, 0.6082] | порог подбирался по F1 на той же валидации, поэтому значение смещено вверх |
| Recall / Precision | 0.700 / 0.486 | — | рабочая точка выбранного порога |
| Что измерено | Значение | Как получено |
|---|---|---|
| ROC-AUC: позвоночник / бедро правое / бедро левое | 0.943 / 0.576 / 0.550 | рабочий чекпоинт, собственная валидация |
| Контрольная задача «позвоночник / бедро» | AUC 1.00 | проверка работоспособности пайплайна, а не клиническая метрика |
| Модель против правила «позвоночник = нарушение» | 0.854 против 0.529 | оценка на всём наборе, включая обучающие снимки, поэтому смещена вверх |
Разбивка по областям нужна потому, что нарушения распределены неравномерно: в позвоночнике 33 из 99 снимков, у бёдер 21–22 из 73–79, а сама область почти однозначно определяется по ширине кадра. Поэтому общий AUC частично отражает различение области, а не только распознавание дефекта. Чтобы отделить одно от другого, выполнена проверка: правило «позвоночник = нарушение» даёт внутри областей 0.50 (подсказки нет), модель — 0.85–0.93. Это означает, что модель использует содержимое снимка, а не только область.
| Метрика (эталон) | только таблица | с суффиксами имён |
|---|---|---|
| ROC-AUC | 0.6764 [0.6309, 0.7218] | 0.6199 [0.5840, 0.6559] |
| PR-AUC | 0.4759 [0.4141, 0.5377] | 0.4046 [0.3702, 0.4391] |
| F1 | 0.5676 [0.5270, 0.6082] | 0.5426 [0.5073, 0.5778] |
| Recall / Precision | 0.700 / 0.486 | 0.863 / 0.404 |
Парная разница (только таблица минус с суффиксами): ROC-AUC +0.0564 [+0.0403, +0.0725],
PR-AUC +0.0713 [+0.0398, +0.1028] — знаки +++++, то есть преимущество на всех пяти
seed'ах. Принято правило «только экспертная таблица». Оговорка, важная для интерпретации: эталон — та
же таблица, поэтому вариант, обучавшийся на ней, находится в выигрышном положении; значимо здесь то,
что добавление ненадёжных пометок согласие с экспертом снижает, а не повышает.
Измерения выполнены на рабочей машине разработчика (macOS, Apple Silicon) на полном наборе данных —
548 файлов в dataset_hack (544 обучающих плюс 4 тестовых). Инференс принудительно
переведён на CPU параметром --device cpu, чтобы числа не зависели от наличия ускорителя.
| Показатель | Значение | Условия |
|---|---|---|
| Время на изображение (медиана) | 0.021 с | CPU, включает чтение DICOM, предобработку и проход сети |
| Время на изображение (максимум) | 0.131 с | тот же прогон; первый снимок включает прогрев |
| Пакет целиком (548 файлов) | 12.1 с | от запуска процесса до записи XLSX, включая загрузку чекпоинта |
| Доля успешно обработанных файлов | 548 / 548 (100 %) | ошибок чтения на этом наборе нет |
| Пиковая память процесса | ≈ 640 МБ | maximum resident set size, пакетный CPU-инференс |
| Ответ API на один файл | 16–18 мс | вызов внутри процесса, после прогрева; первый запрос 390 мс. Здесь устройство выбрано автоматически (MPS), на CPU значение того же порядка — см. медиану пакетного прогона выше |
| Время старта сервиса | ≈ 3 с | импорт библиотек и загрузка чекпоинта |
Отсюда следует прямой ответ на требование «не более 3 минут на исследование»: даже если исследование содержит максимальные по заданию три снимка, обработка занимает доли секунды, а трёхминутный бюджет расходуется практически только на передачу файлов и накладные расходы интеграции. Запас более чем трёхкратный, поэтому узким местом решение не ограничивает.
| Ресурс | Минимальная конфигурация | Рекомендуемая |
|---|---|---|
| Процессор | 2 ядра x86-64 или ARM64 | 4 ядра и более; инференс векторизован и масштабируется по кадрам |
| Оперативная память | 1.5 ГБ (измеренный пик ≈ 640 МБ + запас на ОС и веб-слой) | 4 ГБ |
| Графический ускоритель | Не требуется: torch устанавливается из CPU-индекса, инференс на CPU укладывается в требование по времени | Любой GPU с поддержкой CUDA 12.6, включая H200 (compute capability 9.0) — вариант сборки Dockerfile_cuda |
| Дисковое пространство | базовый образ python:3.11-slim (150 МБ) + зависимости, код и чекпоинт (43 МБ) — всё внутри образа | плюс место под входные архивы DICOM и результаты |
| Сеть | Не требуется при работе: образ и веса фиксированы, обращений во внешние сервисы нет | Нужна только для сборки образа и загрузки базовых зависимостей |
Размер образа (измерено). CPU-вариант: 1.46 ГБ под linux/arm64 и 1.8 ГБ под
linux/amd64. GPU-вариант: 7.0 ГБ под linux/amd64 — почти всё сверх базы
занимают CUDA-библиотеки внутри колёс torch (nvidia-cublas-cu12,
nvidia-cudnn-cu12, nvidia-nccl-cu12 и другие). Базовый образ
python:3.11-slim — 150 МБ; torch и torchvision берутся из CPU-индекса в CPU-варианте и из
индекса cu126 в GPU-варианте, поэтому CUDA-колёса в CPU-образ не попадают (там
torch 2.8.0+cpu и ноль nvidia-пакетов). Данные, тесты, labels/,
assets/ и docs/ в образ не входят; чекпоинт (43 МБ), наоборот, лежит внутри —
монтировать каталог с моделями при запуске не нужно.
| Элемент | Значение |
|---|---|
| Базовый образ | python:3.11-slim (фиксированный тег); у GPU-варианта он тот же — CUDA и cuDNN приходят внутри колёс torch, отдельный nvidia/cuda-образ не нужен |
| Зависимости | requirements.txt с точными версиями; CPU-вариант берёт torch и torchvision из CPU-индекса PyTorch, GPU-вариант — из индекса cu126 |
| Что копируется в образ | src/, requirements.txt, run.sh и чекпоинт models/dxa_model.pth |
| Что не копируется | данные, тесты, labels/, assets/, docs/ (см. .dockerignore) |
| Чекпоинт | копируется на этапе сборки и лежит в образе как /app/models/dxa_model.pth; путь задаётся переменной DXA_MODEL_PATH. Монтировать каталог с моделями не нужно |
| Проверки на этапе сборки | импорт приложения (import src.main), наличие офлайн-ассетов фронтенда и читаемость чекпоинта (ключи backbone, head, threshold); сборка падает при их отсутствии |
| Контроль состояния | HEALTHCHECK обращается к /api/v1/health каждые 30 с |
| Запуск | docker-compose.yml: сервис dxa-cpu поднимается по умолчанию, GPU-сервис dxa-cuda — под профилем cuda |
| Точка входа | uvicorn src.main:app на порту 8000 |
Модель встроена в образ, поэтому штатно чекпоинт всегда на месте. Если файл всё же недоступен
(например, образ повреждён), сервис всё равно поднимается: /api/v1/health сообщает
model_loaded: false, а запросы анализа возвращают ошибку вместо тихой неверной оценки.
Это сознательный выбор: отсутствие модели должно быть заметно сразу, а не проявляться как «странные»
результаты.
Что проверено на самом образе. Сборка проходит три внутренние проверки:
app import ok, frontend assets ok и
checkpoint ok: resnet18 linear threshold -0.4930129051208496. Контейнер запущен без единого
монтирования (docker run -d -p 8000:8000 dxa-quality:cpu): чекпоинт присутствует внутри
образа (/app/models/dxa_model.pth), /api/v1/health сообщает
model_loaded: true, device: cpu, эпоху 39 и файл разметки
labels/labels_images.csv, запрос /api/v1/analyze отвечает корректной строкой
результата, а /api/v1/export возвращает XLSX с ожидаемым набором столбцов. Сквозная
проверка выполнена в контейнере на той же машине, где снимались измерения производительности. Оба
варианта дополнительно собраны под целевой linux/amd64 (эмуляция на той же машине):
CPU-образ содержит torch 2.8.0+cpu и ни одного nvidia-пакета, GPU-образ —
torch 2.8.0+cu126 с cuDNN 9.10.2 и библиотекой libtorch_cuda.so; в обоих
сервис стартует, и /api/v1/health, /api/v1/analyze и
/api/v1/export отвечают корректно (device: cpu, поскольку ускорителя в машине
нет). Работа на самом GPU не проверялась: для неё нужна машина с драйвером NVIDIA, где критерий
приёмки — torch.cuda.is_available() == True и device: cuda в
/api/v1/health.
backbone, head, параметры
предобработки, threshold, а также labels_csv и split_file.
Поэтому по файлу видно, на какой разметке и на каком разбиении получена модель, а инференс не
может рассинхронизироваться с обучением.Jenkinsfile выполняет три шага: сборка образа, публикация в реестр и выкладка в
кластер. Скрипт run.sh — единая точка входа для разработки и эксплуатации: обучение,
разметка, приведение имён файлов, инференс, сервис, сравнение вариантов разметки и тесты
(перечень команд — приложение Б). Для запуска образа есть docker-compose.yml с двумя
сервисами (14.1). Файл выкладки swarm (/data/deploy/rell-bone-2026/docker-swarm.yml) лежит
вне репозитория: если он монтирует каталог с моделями в /app/models, монтирование
перекроет встроенный чекпоинт, поэтому его нужно убрать при обновлении выкладки.
Тесты — pytest, 209 проверок в шести файлах; запуск — ./run.sh test или
python -m pytest tests/ -q. Сверка выполнена на дату документа: 209 passed.
| Файл | Тестов | Что проверяет |
|---|---|---|
tests/test_labels.py | 38 | разбор имён, определение области и метки по имени, стратифицированное разбиение по исследованиям, отсутствие утечки, фиксация и переиспользование разбиения в файле, сверка с реальным датасетом |
tests/test_excel_labels.py | 50 | разметка по экспертной таблице: чтение критериев, правило «1 = нарушение», голосование по
области, перенос оценки на единственное бедро, три правила метки
(table / union / expert), их согласованность и подключение
к обучению |
tests/test_rename_files.py | 36 | приведение имён DICOM: разбор и канонизация, поиск свободного номера при конфликте, отказ угадывать область, цикл «применить → откатить» |
tests/test_preprocess_and_model.py | 32 | конфигурация и нормировка, сборка тензора и нормировка ImageNet, метрики, подбор порога, контракт модели, BatchNorm при заморозке, roundtrip чекпоинта, проверка на реальных снимках |
tests/test_violations.py | 28 | единый словарь типов: приведение устаревших значений, подписи, коды SR и каталог для API, согласованность с критериями экспертной таблицы |
tests/test_api_contract.py | 25 | поля ответов, которые читает веб-интерфейс: базовый и детальный анализ, здоровье и карточка модели, выгрузка XLSX, обработка ошибок; различимость метрик между снимками и валидность PNG-визуализаций |
Отдельный контур — браузерные проверки интерфейса (tests/browser/*.js, Node и
playwright-core): они открывают интерфейс во временном профиле Chrome, загружают DICOM,
кликают по строкам таблицы и снимают содержимое панели деталей. Требуется запущенный сервер на
127.0.0.1:8123; профиль пользователя не затрагивается.
| Сценарий | Что проверяет |
|---|---|
ui_check.js |
подсказку о кликабельности строк и её скрытие при пустом фильтре; открытие панели деталей из строки; изменение значений при переключении строк; наполнение панели «О модели» метриками и словарём |
ui_violation.js |
ветку «нарушение»: бейдж, POOR, HIGH, текст заключения |
ui_offline.js |
отсутствие обращений страницы к внешним хостам |
Требование задания — отсутствие необработанных исключений: сбой на одном файле фиксируется в отчёте и не прерывает пакет. Ниже — фактические режимы отказа и способ обработки.
| Ситуация | Поведение | Где обрабатывается |
|---|---|---|
| Ошибка чтения или обработки файла (CLI) | строка получает quality_class = -1, область unknown, пустые UID и
processing_status = Failure: <Тип>: <сообщение> (до 120 символов);
остальные файлы обрабатываются дальше |
process_one, src/dxa/inference.py |
Неподдерживаемая форма pixel_array (не 2D и не 3D) |
ValueError, превращается в Failure: согласно строке выше |
preprocess.py |
| Чекпоинт отсутствует или не читается | сервис поднимается, /api/v1/health отдаёт model_loaded: false, а
запросы анализа — HTTP 500 {"error": "Model not loaded"} |
load_model(), src/main.py |
| Архитектура чекпоинта не совпала с запрошенной | ValueError с указанием сохранённых backbone / head |
load_model, src/dxa/inference.py |
Чекпоинт — «сырой» state_dict без метаданных |
ValueError: файл не содержит model_state_dict |
DXAQualityModel.load |
Сбой в одиночном запросе /analyze, /analyze/detailed,
/analyze/sr |
HTTP 500 с телом {"error": <текст>, "processing_status": "Failure: <первые 50
символов>"}; детальный эндпоинт дополнительно печатает стек в лог сервера |
обработчики маршрутов |
Сбой одного файла в /api/v1/batch |
элемент становится {"filename", "error", "processing_status": "Failure"},
остальные файлы возвращаются нормально |
batch_analyze |
Сбой одного файла в /api/v1/export |
строка со статусом Failure: <до 80 символов> и quality_class = -1
попадает в XLSX, выгрузка не прерывается |
export_results |
| Файл разметки не найден при обучении | предупреждение в лог и откат на метки из имён файлов; откат залогирован явно, потому что вместе с источником меток меняются метрики | resolve_labels_csv, src/dxa/train.py |
| Пустое разбиение (нет обучающих или валидационных снимков) | RuntimeError с числами train / val до начала обучения |
train() |
model_loaded: false и отклоняет запросы анализа. Молчаливая неверная оценка вместо
явной ошибки была бы опаснее в медицинском контуре.Ограничения сформулированы так, чтобы читатель мог оценить границы применимости решения, а не только увидеть итоговые метрики.
filename_fallback.Laterality пусты, оценка взята из единственного заполненного столбца таблицы.bone_2026/ ├── src/ │ ├── main.py FastAPI: маршруты и загрузка модели │ ├── dxa/ действующий модуль оценки качества │ │ ├── preprocess.py DICOM -> тензор (общий путь для обучения и API) │ │ ├── model.py сеть, метрики, подбор порога, чекпоинт │ │ ├── train.py обучение и отчёт (md/json) │ │ ├── dataset.py DXADataset, DataLoader │ │ ├── inference.py пакетный инференс, определение области, визуализация │ │ ├── labels.py разбор имён, метки, склейка дублей, разбиение │ │ ├── excel_labels.py разметка снимков по экспертной таблице │ │ ├── rename_files.py приведение имён DICOM к единому виду │ │ ├── violations.py единый словарь типов нарушений │ │ ├── model_card.py карточка решения для API и интерфейса │ │ ├── compare_labels.py сравнение источников разметки │ │ ├── discriminator.py проверка вклада содержимого снимка │ │ └── render.py рендер снимков и контактных листов │ ├── quality/ эвристики: измерения снимка │ ├── api/static/ веб-интерфейс (офлайн-ассеты) │ └── utils/ выбор устройства ├── labels/ размеченные данные, разбиение, карта переименований ├── assets/ схемы, скриншоты, обоснование разметки ├── models/dxa_model.pth рабочий чекпоинт и отчёт обучения ├── tests/ pytest + браузерные проверки интерфейса ├── docs/ настоящий документ (HTML и PDF) ├── run.sh, docker-compose.yml, Dockerfile, Dockerfile_cuda, Jenkinsfile, requirements.txt
# обучение и разметка
./run.sh label                          разметить датасет по экспертной таблице
./run.sh rename                         план приведения имён файлов (--apply для применения)
./run.sh train                          обучить модель (режим меток по умолчанию)
./run.sh split && ./run.sh compare       сравнить варианты разметки на одном разбиении

# инференс и сервис
./run.sh infer "dataset_hack/Для теста" results.xlsx
./run.sh serve                          API и веб-интерфейс на порту 8000
python -m src.dxa.discriminator         проверка вклада содержимого снимка

# проверки
./run.sh test                           pytest (209 тестов)
node tests/browser/ui_check.js          проверки интерфейса (нужен сервер на 127.0.0.1:8123)

# контейнер (чекпоинт лежит внутри образа, монтировать пути не нужно)
docker compose up -d                            CPU-сервис в фоне, http://localhost:8000
docker compose --profile cuda up -d dxa-cuda    GPU-сервис (нужен nvidia-container-toolkit)
docker build -t dxa-quality .                   сборка CPU-образа напрямую
docker run -p 8000:8000 dxa-quality             запуск без compose
Документ подготовлен по фактическому состоянию репозитория; машинные отчёты обучения —
models/train_report.json, обоснование разметки — assets/labeling.md.