 denis
0305026ea4 |
||
|---|---|---|
| assets | ||
| docs | ||
| public/static | ||
| src | ||
| tests | ||
| tools | ||
| .dockerignore | ||
| .gitignore | ||
| Dockerfile | ||
| Dockerfile_cuda | ||
| Jenkinsfile | ||
| QWEN.md | ||
| README.md | ||
| condition.txt | ||
| condition_doctor.txt | ||
| requirements.txt | ||
| run.sh | ||
README.md
🦴 DXA Quality Assessment
Сервис автоматизированного контроля качества денситометрических исследований (DXA): принимает DICOM, определяет анатомическую область, оценивает, пригодно ли изображение для клинической интерпретации, и формирует структурированный отчёт.
Что делает решение
| Шаг | Реализация |
|---|---|
| Определение анатомической области | Ширина кадра (позвоночник / бедро) + голова области + геометрия яркой зоны |
| Бинарная оценка качества | ResNet18 (ImageNet) → линейная голова; порог подобран по F1 на валидации |
| Тип нарушения | Общая категория для снимков с нарушением; детальный тип требует разметки типов на уровне снимка |
| Отчёт | XLSX/CSV со столбцами из требований; опционально zip с визуализацией зоны интереса |
| API | FastAPI: анализ, детальный анализ, пакетная обработка, экспорт, DICOM SR (текст) |
| Веб-интерфейс | Загрузка DICOM, таблица результатов, панель деталей с визуализацией, панель «О модели» |
Установка и запуск
python3 -m venv venv && source venv/bin/activate
pip install -r requirements.txt

./run.sh label                                        # разметить датасет по Excel
./run.sh rename                                       # план приведения имён файлов
./run.sh train                                        # обучить модель качества
./run.sh infer "dataset_hack/Для теста" results.xlsx  # пакетная обработка
./run.sh serve                                        # API и веб-интерфейс на :8000
./run.sh split && ./run.sh compare                    # сравнить варианты разметки
./run.sh test                                         # тесты
Для инференса только на CPU (образ меньше, без CUDA-колёс):
pip install -r requirements.txt --extra-index-url https://download.pytorch.org/whl/cpu
Обучение и инференс можно вызывать напрямую:
python -m src.dxa.train --epochs 100 --output-dir models
python -m src.dxa.inference --input-path dataset_hack --output-path results.xlsx --zip-out masks.zip
После запуска сервера:
- Веб-интерфейс: http://localhost:8000
- Swagger UI: http://localhost:8000/docs
Docker
docker build -t dxa-quality .
docker run -v /path/to/data:/data -p 8000:8000 dxa-quality
Чекпоинт должен лежать в models/dxa_model.pth до сборки; путь задаётся переменной
DXA_MODEL_PATH (по умолчанию /app/models/dxa_model.pth). Сборка проверяет, что
чекпоинт читается, и падает, если модели нет — вместо тихих 500-х ответов в рантайме.
Вес модели внутрь образа зашит, из сети ничего не скачивается.
Архитектура
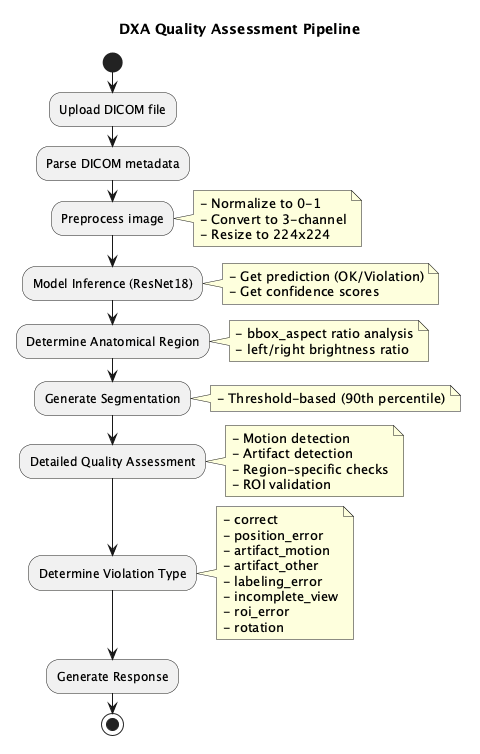
Схема работающего пути в терминах решения:
DICOM ──▶ предобработка ──▶ ResNet18 (заморожен) ──▶ линейная голова ──▶ логит
              │                                            │
              │                                            └──▶ голова области (вспомогательная)
              │
              ├──▶ геометрия яркой зоны: область, ROI, геометрия кадра
              └──▶ эвристики: резкость, «плотные» включения
Ключевые решения и почему они такие:
-
Линейный зонд вместо полного fine-tune. Уникальных снимков в наборе ~250. Полный fine-tune ResNet18 переобучается за несколько эпох (train F1 → 1.0 при val AUC ≈ 0.5). Замороженный backbone + линейная голова удерживает val AUC ≈ 0.7–0.85. Режим
--head mlp --freeze-epochs 0оставлен для экспериментов на большем объёме данных. -
Метки на уровне снимка. Источник —
labels/labels_images.csv, построенный из экспертной таблицы командой./run.sh label(разбор — вassets/labeling.md): в таблице отмечены критерии качества по каждому исследованию, а каждая область встречается в нём ровно один раз, поэтому вердикт переносится на снимок однозначно. Такой разметки — 77 нарушений из 252 (30.6 %). Правило выбрано измерением: учёт ручных пометок из имён файлов дал худший результат на held-out наборе, поэтому в метках они не участвуют. Резервный режим--labels-csv ""берёт метку из суффикса_good/_badи оставлен для совместимости. -
Склейка побайтных дублей. В датасете 544 файла, но 252 уникальных снимка: один и тот же кадр сохранён многократно под разными именами (часть — с меткой, часть — без). Без склейки одно изображение попадало бы в оба класса.
-
Разбиение по исследованиям. Снимки одного исследования не попадают одновременно в train и val — иначе метрики завышаются за счёт утечки.
-
Аугментация отключена. Проверено экспериментально: яркостный разброс и сдвиг кадра снижают AUC с 0.87 до 0.56, потому что распределение яркости и положение области сами являются признаками качества. Флаг
--augmentвключает её для экспериментов. -
Порог по логиту. При доле нарушений ~15 % порог 0.5 даёт нулевой recall. Порог подбирается по F1 на валидации и сохраняется в чекпоинт; решение принимается по логиту (численно устойчиво при насыщении вероятностей).
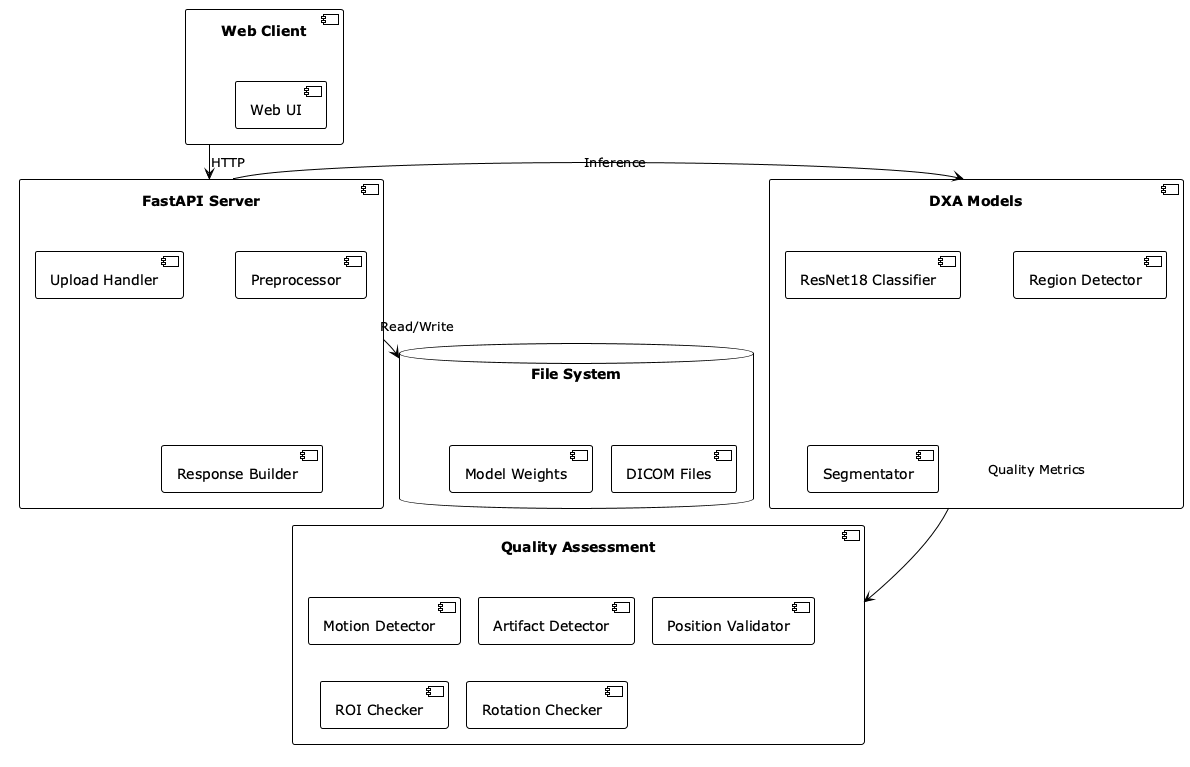
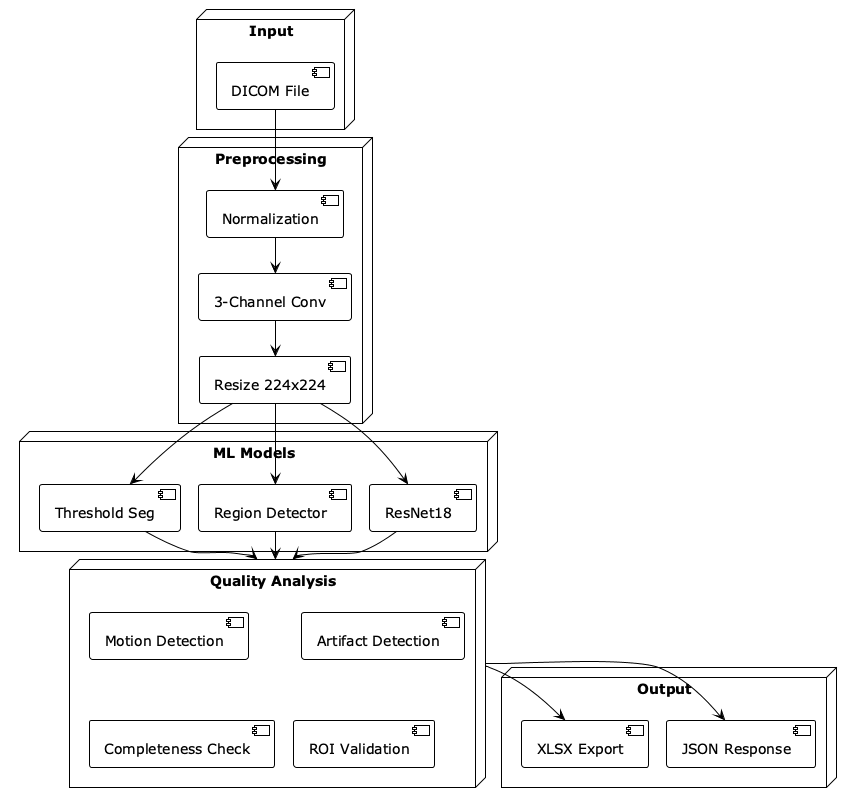
Схемы системы
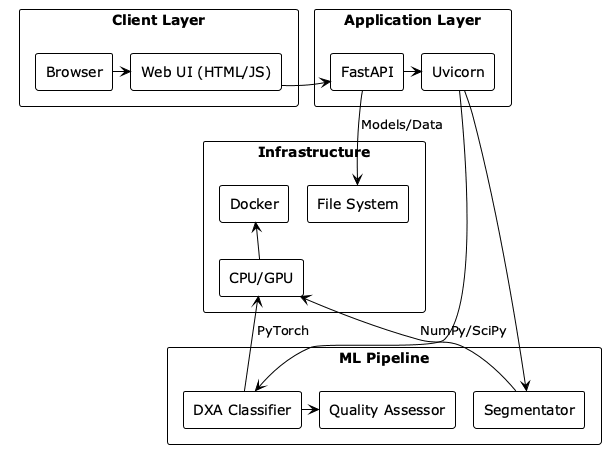
| Компоненты | Поток данных |
|---|---|
 |
 |
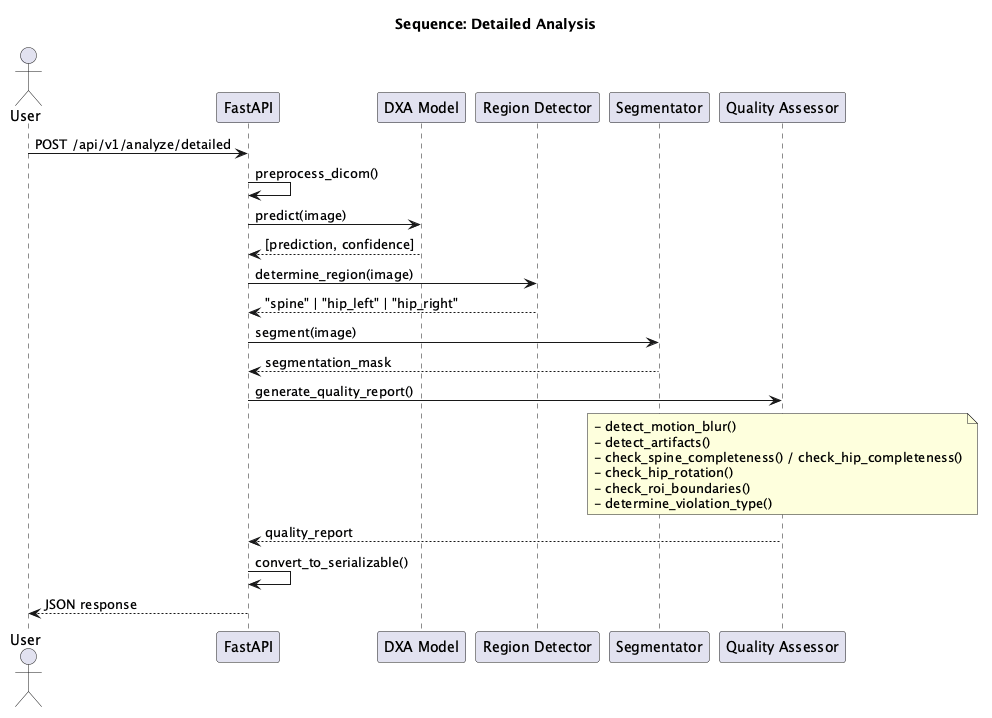
| Последовательность детального анализа | Развёртывание |
|---|---|
 |
 |
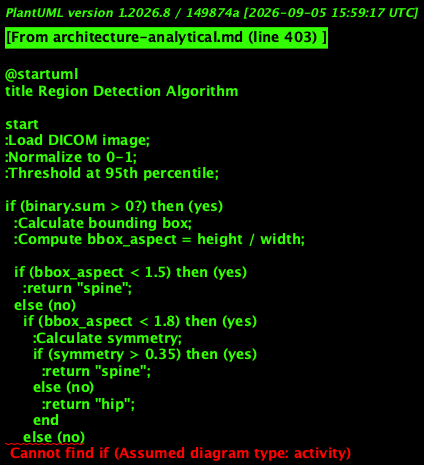
| Определение анатомической области | Основные сущности |
|---|---|
 |
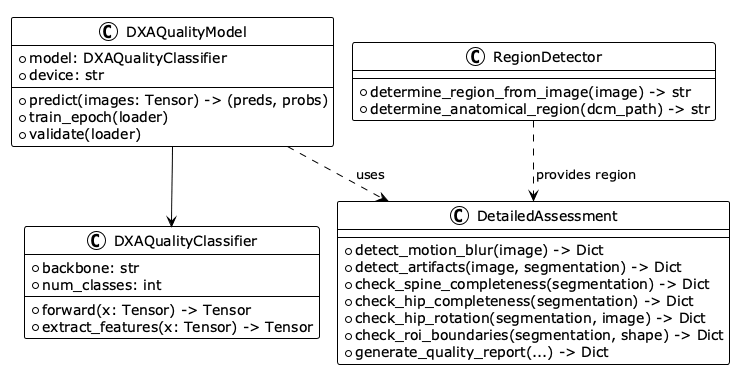 |
Схемы взяты из проектного документа и показывают целевую архитектуру: блоки
Orchestrator, UNet-сегментации и готовых вердиктов качества в API не подключены.
Работающий путь описан выше, неподключённые модули перечислены в разделе
«Структура проекта».
Формат выходных данных
Основные столбцы соответствуют требованиям задания:
| Столбец | Описание |
|---|---|
path_to_study |
Путь к исследованию (для HTTP-загрузки — upload://<имя>) |
study_uid |
StudyInstanceUID |
image_uid |
SOPInstanceUID |
anatomical_region |
spine / hip_left / hip_right / hip |
quality_class |
0 — качественное, 1 — есть нарушение |
violation_type |
Тип нарушения или пустая строка |
processing_status |
Success или Failure: <причина> |
time_of_processing |
Время обработки, секунды |
Дополнительно добавляются confidence, violation_reason, region_confidence
— они не мешают автоматическому разбору обязательных столбцов.
API
| Метод | Путь | Назначение |
|---|---|---|
| GET | / |
Веб-интерфейс |
| GET | /api/v1/health |
Статус, признак загрузки модели и её происхождение |
| GET | /api/v1/model |
Карточка решения: разметка, данные, метрики с интервалами, словарь нарушений |
| POST | /api/v1/analyze |
Базовый анализ одного файла |
| POST | /api/v1/analyze/detailed |
Расширенный отчёт, опционально маска |
| POST | /api/v1/analyze/sr |
Текстовое представление отчёта DICOM SR |
| POST | /api/v1/batch |
Пакетный анализ |
| POST | /api/v1/export |
Пакетный анализ и выгрузка в XLSX |
curl -X POST http://localhost:8000/api/v1/analyze -F "file=@study/spine.dcm"
{
  "study_uid": "1.2.643...",
  "image_uid": "1.2.643...",
  "anatomical_region": "spine",
  "quality_class": 1,
  "quality_label": "Есть нарушение качества",
  "violation_type": "artifact",
  "violation_type_label": "Артефакты и импланты",
  "violation_type_is_heuristic": true,
  "violation_type_note": "Тип нарушения определён эвристикой по метрикам снимка, а не моделью...",
  "reason": "Посторонние включения или артефакты в зоне интереса",
  "confidence": 0.72,
  "threshold_probability": 0.5103,
  "processing_status": "Success"
}
Коды violation_type берутся из единого словаря src/dxa/violations.py
(positioning, axis_deviation, artifact, rotation, roi_incorrect,
motion, incomplete_anatomy, labeling_error, unspecified) — первые пять
кодирует экспертная таблица, остальные приходят из критериев пригодности. Поле
violation_type_is_heuristic показывает, что тип определён эвристикой, а не
моделью: модель решает только бинарную задачу. Подписи для интерфейса отдаёт
сервер, своей копии словаря фронтенд не держит.
Веб-интерфейс
Полоса состояния в шапке показывает, какая модель сейчас работает: имя чекпоинта, источник разметки, эпоху и порог. По интерфейсу сразу видно, какая версия решения отвечает, — без обращения к логам.

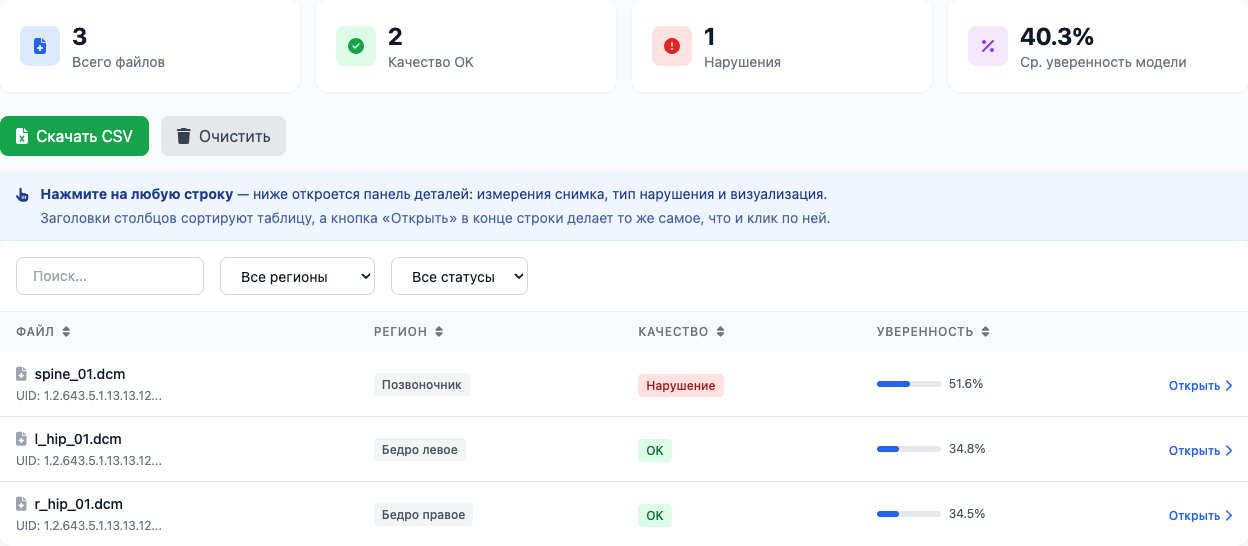
Строки таблицы результатов кликабельны, но об этом надо сказать прямо — иначе не догадываются. Над таблицей висит подсказка «Нажмите на любую строку», в конце каждой строки есть кнопка «Открыть», а клик по строке прокручивает страницу к панели деталей. Подсказка скрывается, когда фильтр не оставил ни одной строки. Кнопка «Открыть» — настоящая кнопка, поэтому панель доступна и с клавиатуры (Tab + Enter), а не только мышью. Сама таблица со статистикой и подсказкой — на первом скриншоте.
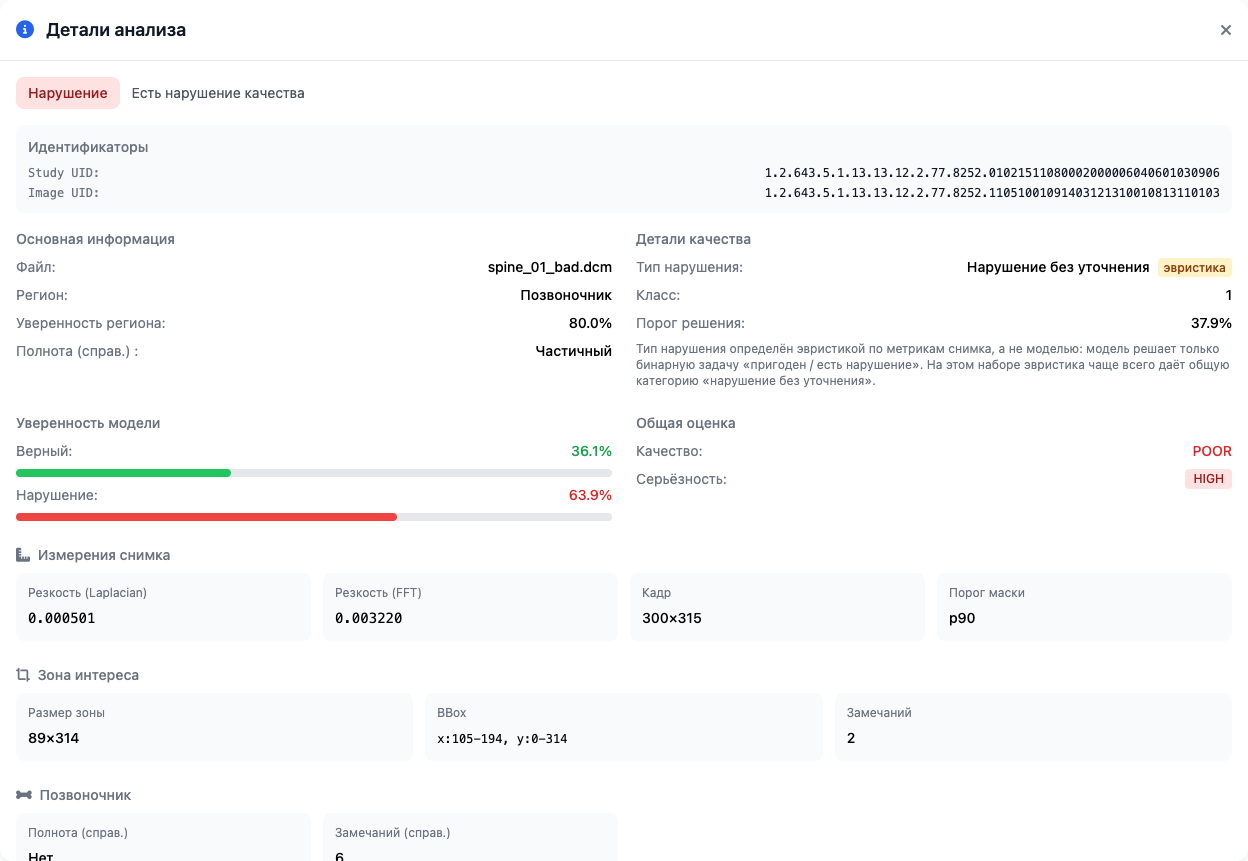
Панель деталей открывается по клику на строку: заключение, измерения и визуализация снимка. Специально показаны обе ветки — «нарушение» и «норма»:
 |
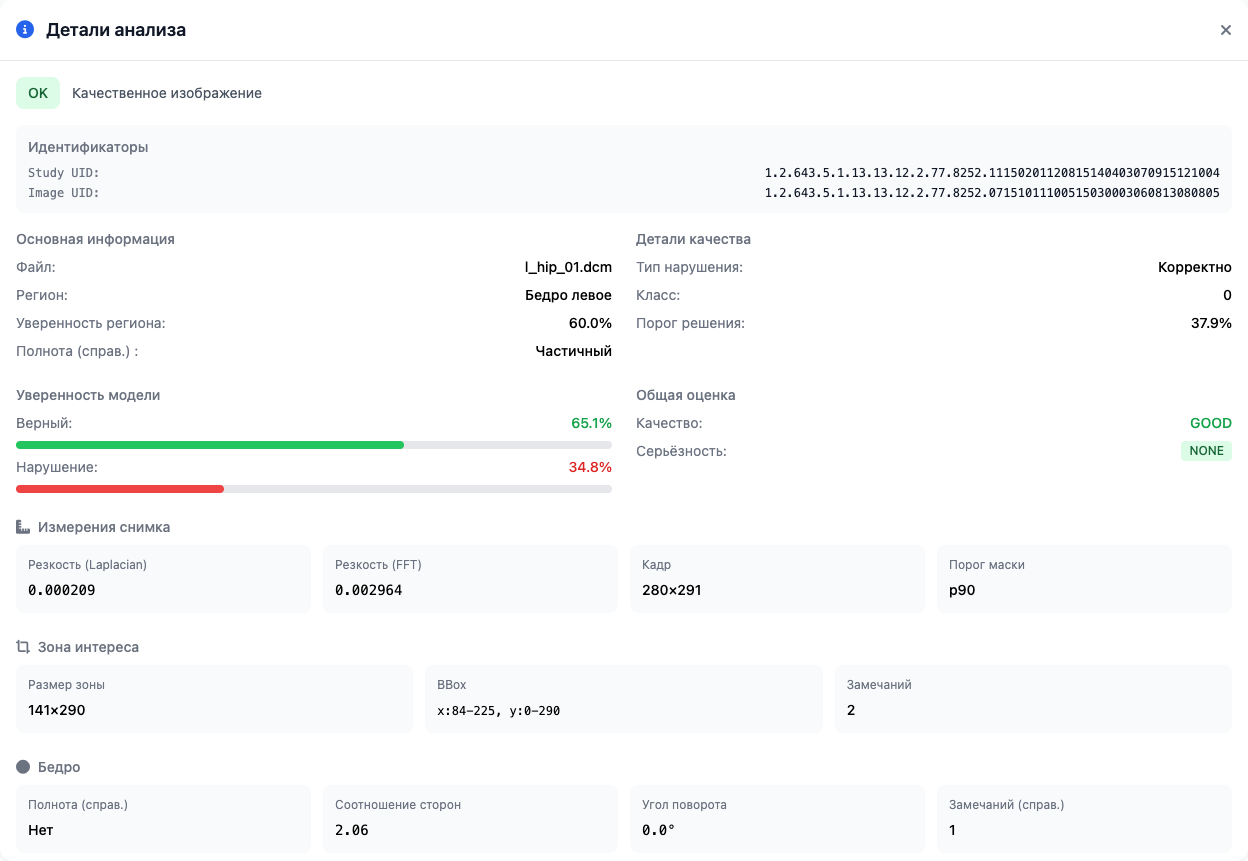 |
| Нарушение. Бейдж «Нарушение», уровень HIGH, заключение с вероятностью и порогом, тип нарушения с пометкой «эвристика». | Норма. Зелёный бейдж. Измерения (резкость, границы области) подписаны как справочные — их пороги не калиброваны. |
Панель «О модели» (кнопка в шапке): что за чекпоинт работает, на какой разметке он обучен, с каким порогом решает, метрики сравнения с 95 % интервалами, состав данных, словарь типов нарушений и список ограничений.
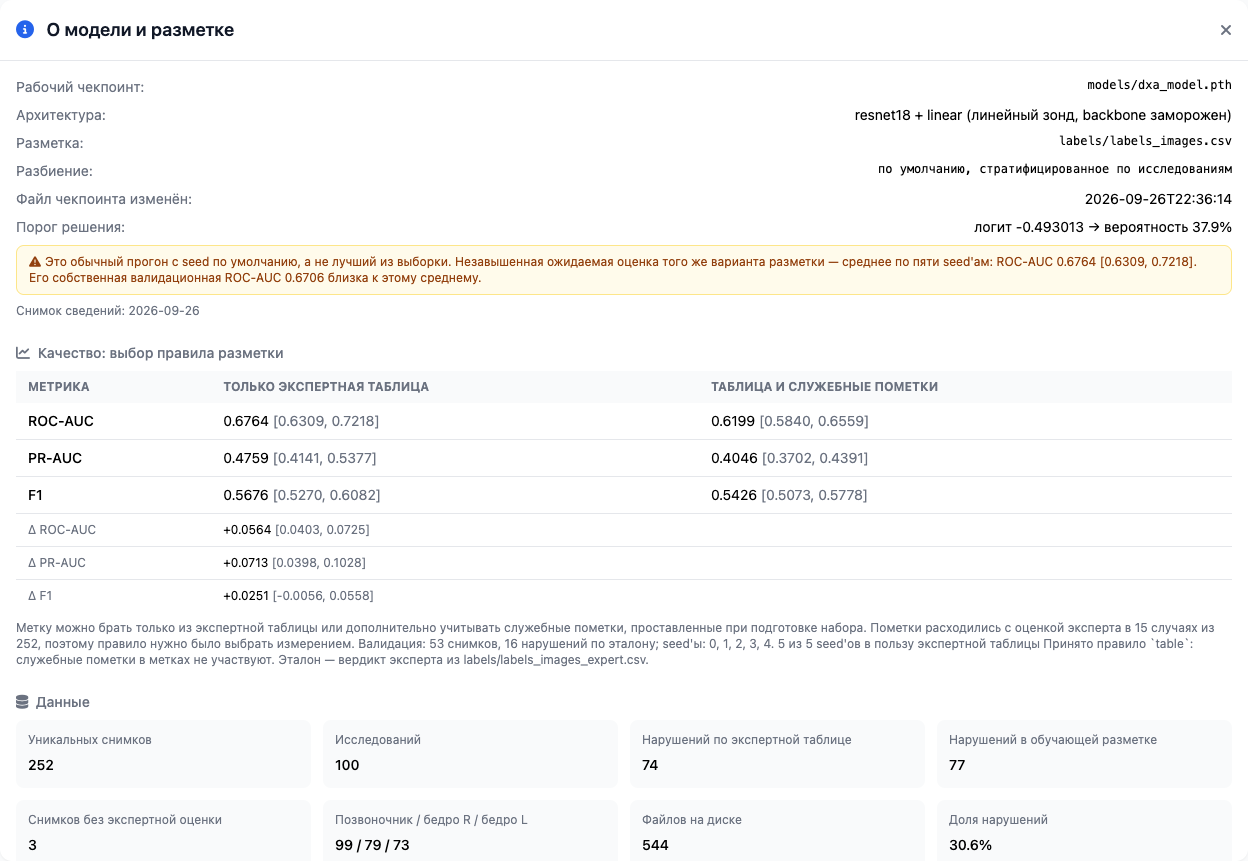
Источник всех этих значений — сервер (/api/v1/health, /api/v1/model).
Фронтенд намеренно не держит собственных копий: раньше подписи типов нарушений
были продублированы в dxa-app.js и разошлись с серверными, из-за чего коды
экспертной таблицы показывались как есть.
Что интерфейс теперь не утверждает:
- тип нарушения помечен как «эвристика» с пояснением — модель решает только бинарную задачу и тип не предсказывает;
- метрика рабочего чекпоинта помечена как завышенная прямо в баннере состояния и в карточке: чекпоинт выбран лучшим из пяти seed'ов, честная оценка варианта — среднее по seed'ам;
- плитка «Ср. уверенность модели» больше не называется точностью: точность требует эталонных меток, которых для произвольного файла нет;
- числовые метрики в панели деталей по-прежнему идут под дисклеймером о некалиброванности порогов.
Метрики
Метрики зависят от выбранного разбиения по исследованиям, поэтому приводятся с разбросом. Основная оценка — на фиксированном разбиении по исследованиям (обучение 199 снимков / 81 исследование, валидация 53 снимка / 19 исследований, 16 нарушений), пять seed'ов обучения, эталон — вердикт эксперта:
| Что измерено | Значение | Как измерено |
|---|---|---|
| ROC-AUC | 0.6764 [0.6309, 0.7218] | 5 seed'ов на фиксированном разбиении |
| PR-AUC | 0.4759 [0.4141, 0.5377] | там же; базовый уровень при 30 % нарушений — 0.30 |
| F1 | 0.5676 [0.5270, 0.6082] | там же; порог подобран на той же валидации — смещено вверх |
| ROC-AUC по областям | позвоночник 0.943, бедро R 0.576, бедро L 0.550 | рабочий чекпоинт, собственная валидация |
| Контрольная задача «позвоночник / бедро» | AUC 1.00 | проверка работоспособности пайплайна |
| Модель использует снимок, а не область | AUC 0.854 против 0.529 у правила области | discriminator на всём наборе, включая обучающие снимки |
Метрики по областям — в models/train_report.md, он создаётся при обучении.
Разбивка важна, потому что нарушения распределены неравномерно: в позвоночнике
33 из 99, у бёдер 21–22 из 73–79, а область почти однозначно определяется по
ширине кадра. Поэтому общий AUC частично отражает различение области, а не только
распознавание дефекта.
Выбор правила разметки
Метку можно было строить только из экспертной таблицы или дополнительно
учитывать пометки, проставленные вручную в именах файлов (суффикс _bad).
Пометки расходились с оценкой эксперта в 15 случаях из 252, поэтому правило
выбиралось измерением: одно разбиение, пять seed'ов, один эталон.
| Метрика (эталон) | только таблица | с суффиксами имён |
|---|---|---|
| ROC-AUC | 0.6764 [0.6309, 0.7218] | 0.6199 [0.5840, 0.6559] |
| PR-AUC | 0.4759 [0.4141, 0.5377] | 0.4046 [0.3702, 0.4391] |
| F1 | 0.5676 [0.5270, 0.6082] | 0.5426 [0.5073, 0.5778] |
| Recall / Precision | 0.700 / 0.486 | 0.863 / 0.404 |
Парная разница (только таблица − с суффиксами): ROC-AUC +0.0564
[+0.0403, +0.0725], PR-AUC +0.0713 [+0.0398, +0.1028] — знаки +++++, то
есть преимущество на всех пяти seed'ах.
Принято правило «только экспертная таблица». Пометки в именах файлов проставлялись вручную и оказались ненадёжными: они ухудшали согласие модели с экспертом на невиданных исследованиях. Оговорка: эталон — та же таблица, поэтому вариант, обучавшийся на ней, в выигрышном положении; значимо то, что добавление ненадёжных пометок согласие снижает.
Отчёт с полными числами и разбором ограничений — assets/labeling.md;
машинные отчёты — models/compare_rules/rule_comparison.md и
models/train_report.json.
Время обработки одного снимка — порядка 0.02–0.05 с на CPU (ResNet18 с замороженным backbone), то есть требование «не более 3 минут на исследование» выполняется с большим запасом.
Ограничения (важно для интерпретации)
-
Разметка выведена из оценки исследования. Экспертная таблица описывает исследование, а не снимок; перенос однозначен (область встречается один раз), но поштучной экспертной оценки снимков в наборе нет. Происхождение каждой строки зафиксировано в
labels/labels_images.csv. Разбор — вassets/labeling.md. -
Мало данных. 252 уникальных снимка, 77 нарушений. Доверительные интервалы широкие; оценка на закрытом наборе может отличаться.
-
Тип нарушения определяется эвристиками, а не обученной моделью. Для честного мультикласса нужна разметка типов на уровне снимка.
-
Область определяется по размеру кадра. Признак безошибочно работает на этом оборудовании (99/99 для позвоночника), но при смене аппарата порог
SPINE_MIN_WIDTHпотребует калибровки. -
В DICOM нет разметки ROI. Ни overlay, ни graphic annotation в файлах нет, поэтому корректность нанесённых областей измерения нельзя проверить прямым сравнением — оценивается только геометрия видимой зоны.
-
Эвристики из
src/quality/detailed_assessment.pyне калиброваны. Пороги для «движения», «артефактов» и отступов ROI рассчитаны на другой масштаб интенсивностей: на этом наборе они срабатывают почти для любого снимка, а признак резкости ведёт себя противоположно в позвоночнике и бёдрах. Поэтому в панели деталей показываются числовые измерения с пометкой «справ.», а не вердикты «Да/Нет». Классификацию выполняет только модель. Проверить её вклад можно командой:python -m src.dxa.discriminator --model-path models/dxa_model.pth
Что проверено и как
| Проверка | Команда | Результат |
|---|---|---|
| Модель использует снимок, а не только область | python -m src.dxa.discriminator |
AUC 0.854 против 0.529 у правила «позвоночник = нарушение»; внутри областей у модели 0.85–0.93, у правила 0.50 |
| Контракт API для веб-интерфейса | python -m pytest tests/test_api_contract.py |
поля панели деталей, различимость метрик, PNG-визуализации, отсутствие некалиброванных вердиктов, канонические коды типов нарушений, карточка модели |
| Единый словарь нарушений | python -m pytest tests/test_violations.py |
коды, подписи, коды SR, приведение устаревших значений, согласованность с таблицей |
| Разметка и разбиение данных | python -m pytest tests/test_labels.py |
склейка дублей, разбор имён, фиксация разбиения, отсутствие утечки между train/val |
| Имена DICOM-файлов | python -m pytest tests/test_rename_files.py |
разбор имён, поиск свободного номера при конфликте, отказ от угадывания области, цикл «применить → откатить» |
| Разметка по экспертной таблице | python -m pytest tests/test_excel_labels.py |
чтение критериев, голосование по области, перенос на единственное бедро, правила table/union/expert, подключение к обучению |
| Выбор правила метки | ./run.sh split && ./run.sh compare |
ROC-AUC 0.6764 против 0.6199 по эталону, парная Δ +0.0564 [+0.0403, +0.0725], 5/5 seed'ов в пользу экспертной таблицы |
| Метрики и порог | python -m pytest tests/test_preprocess_and_model.py |
подбор порога при дисбалансе, roundtrip чекпоинта, BatchNorm |
| Веб-интерфейс в браузере | node tests/browser/ui_check.js |
подсказка о кликабельности строк видна и скрывается на пустом фильтре; кнопка «Открыть» открывает панель; значения панели меняются при переключении строк; панель «О модели» наполняется метриками и словарём |
| Работа без сети | node tests/browser/ui_offline.js |
ноль внешних запросов, стили и иконки на месте |
Браузерные проверки требуют запущенного сервера:
python -m uvicorn src.main:app --port 8123
node tests/browser/ui_check.js      # панель деталей обновляется по клику
node tests/browser/ui_offline.js    # работа без доступа к внешним сервисам
Офлайн-режим обеспечен локальными копиями Tailwind и FontAwesome
(src/api/static/vendor, src/api/static/webfonts); страница не обращается к CDN.
План доработки
- Разметить типы нарушений на уровне снимка и обучить мультилейбл-классификатор.
- Собрать 500+ исследований для устойчивых метрик и честной валидации.
- Подключить Grad-CAM для объяснения решения (модуль есть, но не интегрирован).
- Заменить порог по ширине кадра на калибровку по метаданным аппарата.
Структура проекта
bone_2026/
├── src/
│   ├── main.py                     # FastAPI: маршруты и загрузка модели
│   ├── dxa/                        # действующий модуль оценки качества
│   │   ├── labels.py               # разбор имён, метки, склейка дублей, сплит
│   │   ├── excel_labels.py         # разметка снимков по экспертной таблице
│   │   ├── rename_files.py         # приведение имён DICOM к единому виду
│   │   ├── violations.py           # единый словарь типов нарушений (коды, подписи)
│   │   ├── model_card.py           # карточка решения для /api/v1/model и интерфейса
│   │   ├── compare_labels.py       # сравнение источников разметки на одном наборе
│   │   ├── discriminator.py        # проверка вклада содержимого снимка
│   │   ├── render.py               # рендер снимков и контактных листов
│   │   ├── preprocess.py           # DICOM -> тензор (общий для обучения и API)
│   │   ├── dataset.py              # Dataset и DataLoader
│   │   ├── model.py                # сеть, метрики, подбор порога
│   │   ├── train.py                # обучение и отчёт
│   │   └── inference.py            # пакетный инференс, определение области
│   ├── quality/                    # эвристики (частично используются API)
│   ├── api/static/                 # веб-интерфейс
│   └── model/, core/, pipeline/    # устаревшие модули, не подключены к API
├── labels/labels_images.csv        # разметка снимков: официальная (+ .xlsx)
├── labels/labels_images_table.csv  # вариант «только таблица» (то же, что выше)
├── labels/labels_images_union.csv  # вариант «таблица или суффикс имени»
├── labels/labels_images_expert.csv # эталон для оценки: только снимки с оценкой
├── labels/split_expert_seed42.json # зафиксированное разбиение (19 исследований)
├── labels/rename_map.csv           # карта переименований файлов (для отката)
├── assets/img/                     # схемы архитектуры и скриншоты интерфейса
├── assets/labeling.md              # как построена разметка и как сравнивались варианты
├── models/dxa_model.pth            # рабочий чекпоинт (+ train_report.md)
├── models/archive/                 # прежние чекпоинты (см. README внутри)
├── models/compare_rules/           # чекпоинты и отчёт сравнения правил метки
├── tests/                          # pytest: метки, сплит, метрики, модель, API
├── dataset_hack/                   # данные (в git не хранятся)
├── Dockerfile
├── requirements.txt
└── run.sh
Запуск обучения
python -m src.dxa.train --epochs 100 --output-dir models
| Параметр | По умолчанию | Описание |
|---|---|---|
--data-root |
dataset_hack |
Каталог датасета |
--annotation-path |
dataset_hack/НД_для_обучения/разметка.xlsx |
Excel с разметкой (только отчёт о расхождениях) |
--labels-csv |
labels/labels_images.csv |
Разметка снимков из ./run.sh label; пустая строка — метки из имён файлов; отсутствующий файл — откат к именам с предупреждением |
--split-file |
— | Зафиксированное разбиение из ./run.sh split; одинаковый held-out набор для сравнения вариантов разметки |
--backbone |
resnet18 |
resnet18 / resnet34 |
--head |
linear |
linear (линейный зонд) / mlp |
--freeze-epochs |
-1 |
-1 — backbone заморожен всегда; 0 — обучать всю сеть |
--epochs, --batch-size, --learning-rate, --weight-decay |
100 / 16 / 3e-4 / 5e-2 | Оптимизация |
--balance |
none |
loss / sampler для компенсации дисбаланса |
--val-fraction, --seed |
0.2 / 42 | Разбиение по исследованиям |
--augment |
выключено | Включает яркостную аугментацию (ухудшает метрики, см. п. 5) |
--output-dir |
models |
Куда сохранять чекпоинт и отчёты |
--dry-run |
— | Проверить разбор данных и разбиение без обучения |
После обучения в --output-dir появляются dxa_model.pth, train_report.md
и train_report.json; отчёт удобно приложить к презентации.
Команда
- Грачев Денис — разработка
- Грачев Татьяна — капитан